Apagón digital: la caída global de Microsoft Outlook 365 del 12 de noviembre - El día en que el correo del mundo dejó de abrir - EX1550543
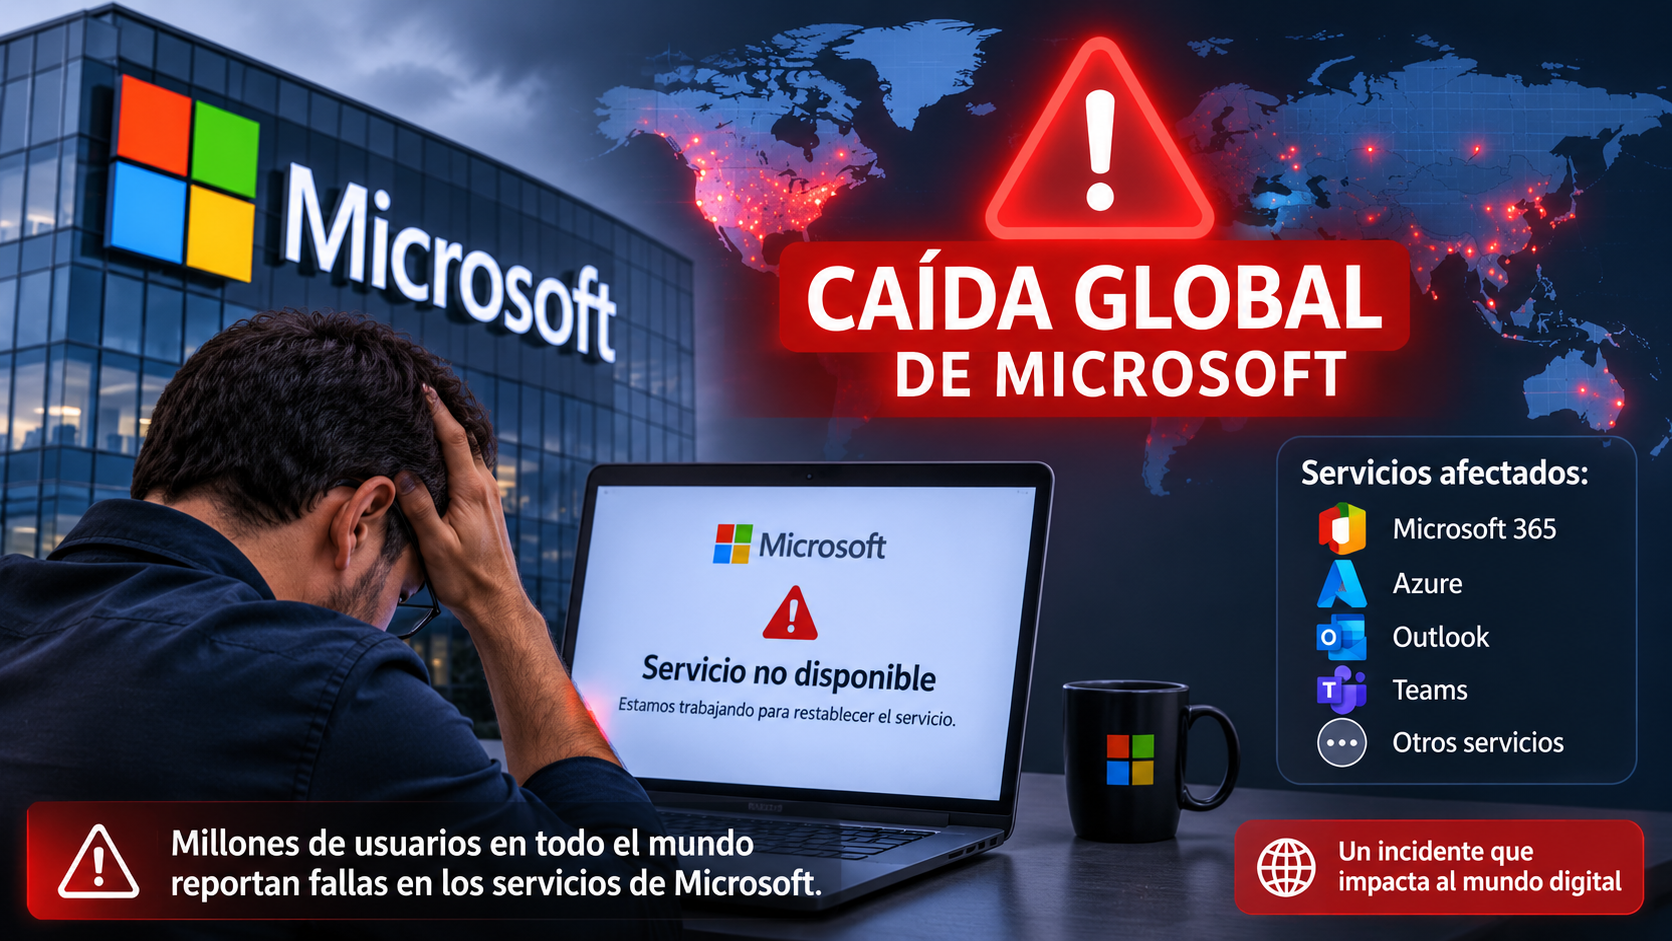
Una falla en la infraestructura de Microsoft dejó sin acceso a Outlook, Teams y Copilot a usuarios de América y Europa durante la tarde del jueves 12 de noviembre. La empresa habló de una carga inusual en sus servidores, pero no confirmó la causa de fondo.
En desarrollo. Esta nota se está escribiendo mientras pasa lo que cuenta: vuelve dentro de un rato y habrá más.
El día en que el correo del mundo dejó de abrir
Poco después del mediodía del jueves 12 de noviembre, millones de oficinas descubrieron al mismo tiempo que su bandeja de entrada no cargaba. No era el wifi ni el computador: era la nube. Los servicios de Microsoft 365 —Outlook, Teams, Copilot, OneDrive y la propia consola de Azure— empezaron a devolver errores de conexión de forma simultánea en América y buena parte de Europa.
La escala quedó registrada en Downdetector, el sitio que agrega reportes de usuarios: a la 1:27 de la tarde, hora del este de Estados Unidos, la plataforma acumulaba más de 130.000 quejas sobre Outlook, más de 46.000 sobre Microsoft 365 y alrededor de 3.000 sobre Teams, según el recuento difundido por la agencia Reuters. La cifra real de afectados casi siempre es mayor: solo una fracción de quienes sufren una caída se toma el trabajo de reportarla.
Lo que sigue es la reconstrucción de una jornada que volvió a exhibir la misma fragilidad de siempre: cuando falla un proveedor, falla el trabajo de medio planeta.
Cronología de una tarde sin correo
Todas las horas corresponden al huso del este de Estados Unidos, que en noviembre coincide con la hora de Colombia, Perú y Ecuador.
| Hora | Qué ocurrió |
|---|---|
| Mañana | Microsoft informa que reparó una interrupción previa de Teams en Norteamérica y la da por resuelta (Reuters) |
| 12:30 p. m. | Downdetector empieza a registrar un alza brusca de reportes sobre servicios de Microsoft (Yahoo News) |
| 12:54 p. m. | La cuenta oficial Microsoft 365 Status reconoce públicamente fallas de acceso a buzones de Exchange Online en América (Yahoo News) |
| 1:00 p. m. | El pico de reportes alcanza también a Azure y a Amazon Web Services (WISH-TV) |
| 1:27 p. m. | Downdetector supera las 130.000 quejas por Outlook, 46.000 por Microsoft 365 y unas 3.000 por Teams (Reuters) |
| 1:32 p. m. | Microsoft informa que está redistribuyendo tráfico entre su infraestructura mundial y reiniciando servidores afectados (foro de estado) |
| 2:00 p. m. | La empresa aún no anuncia una causa raíz ni una hora estimada de restablecimiento (seguimiento del incidente) |
La versión oficial: mucha carga y ninguna causa
El primer mensaje de Microsoft acotó el problema a América y a un síntoma concreto: los usuarios no lograban llegar a sus buzones de Exchange Online por ninguna de las vías habituales, ni el navegador, ni la aplicación de escritorio, ni el teléfono. Una hora después la compañía amplió el perímetro y admitió que la conectividad de Microsoft 365 podía verse comprometida en cualquier región del mundo.
Sobre el origen, la empresa fue mucho más cauta. Dijo haber detectado que una parte de su infraestructura soportaba una demanda inusualmente alta en varias regiones a la vez, y que eso contribuía probablemente a los errores de conexión. No es un diagnóstico: es una pista. Microsoft añadió que había recogido registros de red para rastrear el origen de los fallos y que estaba verificando si ese exceso de tráfico correspondía a un aumento real de peticiones o a un cambio en la forma en que el tráfico se estaba enrutando entre sus centros de datos.
La diferencia entre ambas hipótesis no es menor. Un aumento genuino de peticiones apuntaría a un pico de demanda o a un comportamiento anómalo de clientes; un desvío de enrutamiento sugeriría, en cambio, un error de configuración interno, el mismo tipo de causa que ha estado detrás de varias de las grandes interrupciones de los últimos años.
Para los administradores de sistemas, el episodio quedó registrado como el incidente EX1550543 en el centro de administración de Microsoft 365, la ficha donde las áreas de TI siguen en tiempo real el alcance y la mitigación. Hasta el cierre de esta edición, Microsoft no había publicado ni una causa raíz confirmada ni una hora estimada de recuperación total, ni había cuantificado cuántos usuarios quedaron sin servicio.
Un dato que conviene subrayar para no alimentar pánicos: la compañía describió la falla como un problema de acceso a los buzones, no de entrega de mensajes. Cuando un servidor de correo no puede recibir, los servidores que envían suelen retener los mensajes y reintentar durante días antes de devolverlos. La probabilidad de pérdida definitiva de correos, en escenarios como este, es baja.
¿Se cayó algo más?
Durante esa misma hora aparecieron reportes de Amazon Web Services, Google y Steam, y bastantes usuarios señalaron también a Cloudflare. Una televisora estadounidense llegó a informar que Azure y AWS, las dos infraestructuras que alquilan capacidad de cómputo a medio internet, estaban afectadas al tiempo.
Conviene tomarlo con calma. En toda caída grande pasa lo mismo: el usuario que no puede abrir su correo entra a un detector de fallas y marca todo lo que se le ocurre, funcione o no. Varios ingenieros lo advirtieron ese día en foros técnicos, y los tableros independientes de Cloudflare solo registraban incidencias menores y mantenimientos programados, nada parecido a una caída mundial.
Mientras no haya un informe técnico de por medio, lo sensato es pensar que el problema estuvo en la infraestructura de Microsoft y que buena parte del ruido alrededor fue gente desorientada buscando dónde quejarse.
Ese mismo día, y como si faltara algo, circuló en redes el rumor de un apagón mundial de internet y de los satélites. Operadores y autoridades lo desmintieron: la fibra óptica y los sistemas de posicionamiento funcionaban con normalidad. El bulo había nacido de la mala lectura de un documento técnico y lo amplificaron cuentas automáticas.
Qué hacer?
Ninguna empresa pequeña va a dejar de usar Microsoft 365 por una tarde mala. Pero sí puede reducir el daño de la próxima.
- Tener un canal de respaldo acordado de antemano. Un grupo de mensajería, una lista de teléfonos, lo que sea, siempre que no dependa del mismo proveedor que se cayó.
- No reenviar ni reintentar en masa. Pulsar “enviar” quince veces agrava la congestión y no adelanta nada; los servidores que envían reintentan solos durante días.
- Guardar copias locales de lo crítico. Contratos, facturas del día, el cierre de la edición: si solo vive en la nube, no existe mientras la nube no responda.
- Seguir la fuente oficial, no el rumor. La página de estado del proveedor y su cuenta de incidencias dicen más que cualquier captura de pantalla viral.
- Dejar constancia para el cliente. Un aviso breve explicando que la interrupción es del proveedor evita que el usuario final crea que lo están ignorando.
Y una recomendación técnica que salió del propio episodio: cuando el servicio empieza a volver pero el equipo sigue sin conectarse, limpiar la caché local de DNS suele acelerar la recuperación.
El incidente sigue abierto. Microsoft repartía tráfico entre otros servidores y reiniciaba los que habían quedado atascados, sin causa confirmada ni hora de regreso. Si la revista es impresa, vale la pena cerrar con una línea que ubique al lector en el tiempo; si es digital, conviene revisar el estado antes de publicar.
Nota para la redacción: el texto está escrito en lenguaje propio y las declaraciones de Microsoft van parafraseadas y atribuidas, que es la forma segura de usarlas. Si quiere citar textualmente, limite la cita a una frase corta entre comillas. Para ilustrar, lo más limpio es una captura propia de la página de estado del servicio o una infografía hecha en casa: las fotos de agencia y las capturas de otros medios necesitan licencia.
Fuentes consultadas
- Reuters — Microsoft 365 y Outlook caídos para miles de usuarios, según Downdetector
- KKTV — La interrupción de Microsoft afecta el correo y otros servicios
- Windows Central — Microsoft 365, Outlook, Teams, OneDrive y Copilot caídos
- WISH-TV — Qué más se vio afectado en la caída del jueves
- WindowsForum — Análisis del incidente de Exchange Online
- Seguimiento del incidente EX1550543
- The Register — La caída de Microsoft 365 de enero de 2026
- Mobile Time — Las caídas digitales de 2025
- Ecosistema Startup — Cloudflare documentó 49 apagones en el tercer trimestre de 2026
- Desmentido del supuesto apagón mundial de noviembre de 2026
Nota para la redacción: el texto está escrito en lenguaje propio y las declaraciones de Microsoft van parafraseadas y atribuidas, que es la forma segura de usarlas. Si quiere citar textualmente, limite la cita a una frase corta entre comillas. Para ilustrar, lo más limpio es una captura propia de la página de estado del servicio o una infografía hecha en casa: las fotos de agencia y las capturas de otros medios necesitan licencia.